Menschliche Aufsicht über KI: Warum der Freigabeklick allein keine Fehler findet
Auf unseren eigenen Leistungsseiten steht der Satz, dass ohne Freigabe nichts an Kunden oder Lieferanten geht. Fast jeder Anbieter von KI-Agenten gibt dieses Versprechen. Es hält nur, wenn die Freigabe den Fehler auch findet.
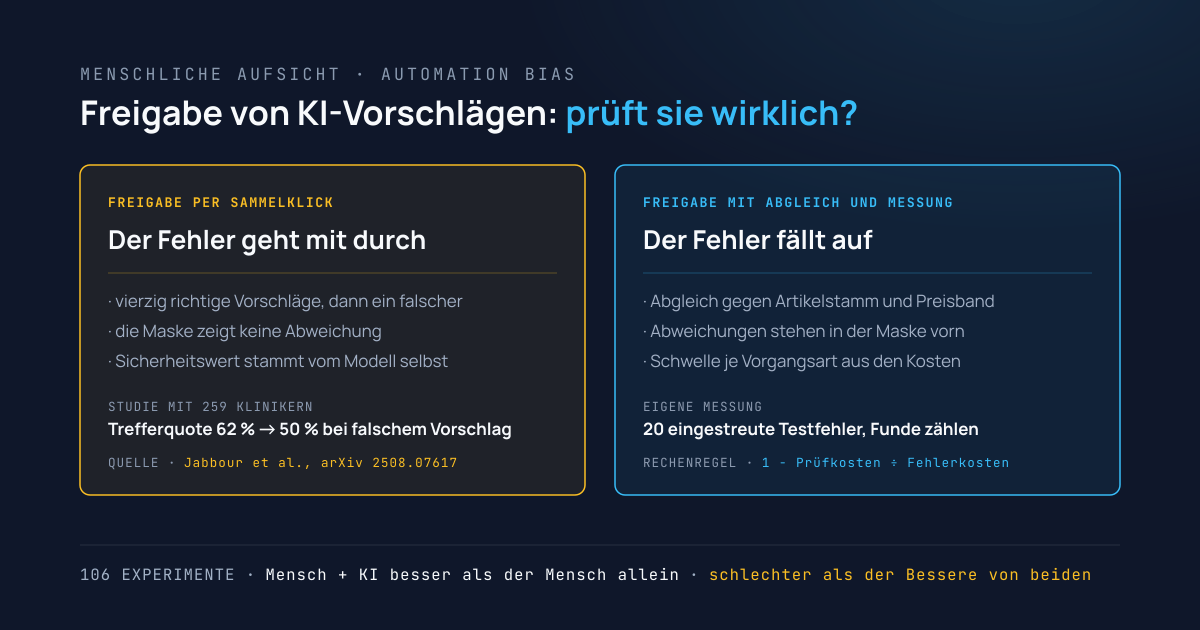
Die Forschung ist an dieser Stelle unbequem. Forscher des Massachusetts Institute of Technology haben 106 Experimente ausgewertet, in denen Menschen mit KI-Unterstützung entschieden haben. Im Schnitt schnitt das Gespann schlechter ab als der Bessere von beiden allein (Vaccaro, Almaatouq und Malone, Nature Human Behaviour, 28.10.2024). Dieser Beitrag ordnet fünf Fachquellen für den Betrieb im Großhandel ein und liefert zwei Rechentabellen für die eigene Prüfung.
Worum es geht: die Kurzfassung
- Automation Bias ist gesetzlich benannt. Art. 14 der KI-Verordnung verlangt, dass beaufsichtigende Personen sich der Neigung zu übermäßigem Vertrauen in die Ausgabe eines KI-Systems bewusst bleiben (Verordnung (EU) 2024/1689).
- Mensch plus KI schlägt den Menschen, aber selten beide. Die Auswertung von 106 Experimenten ergab einen Zugewinn gegenüber dem Menschen allein (g = 0,64) und einen Verlust gegenüber dem Besseren von beiden (g = −0,23).
- Falsche Vorschläge ziehen Entscheidungen mit. In einer Studie mit 259 Klinikern sank die Trefferquote von 62 auf 50 Prozent, sobald ein falscher KI-Vorschlag sichtbar war (Jabbour et al., arXiv 2508.07617).
- Sprachmodelle zeigen ihre Unsicherheit kaum an. In einer Studie zur Ticket-Zuordnung gab ein Modell jedem Fall die Sicherheit 1,0 bei 45,9 Prozent Treffern (Gupta, arXiv 2610.31657).
- Ob Ihre Freigabe prüft, lässt sich messen. Die Schwelle für den Durchlauf ohne Freigabe folgt aus dem Verhältnis von Prüfkosten zu Fehlerkosten. Die Erkennungsquote Ihrer Prüfer ermitteln Sie mit eingestreuten Testfehlern.
Was ist Automation Bias?
Automation Bias ist die Neigung, den Vorschlag eines automatischen Systems zu übernehmen, ohne ihn ausreichend zu prüfen. Die KI-Verordnung spricht in Art. 14 Abs. 4 Buchstabe b von einer möglichen „Neigung zu einem automatischen oder übermäßigen Vertrauen“ in die Ausgabe eines Hochrisiko-KI-Systems. Sie nennt das Automatisierungsbias.
Der Begriff ist älter als Sprachmodelle; frühere Übersichten behandelten ihn für klassische computergestützte Entscheidungen. Giuseppe Romeo und Daniela Conti haben 35 begutachtete Studien aus den Jahren 2015 bis 2025 zu KI-gestützter Arbeit ausgewertet (AI & Society 41, veröffentlicht am 03.07.2025). Als Einflussgrößen nennen sie unter anderem die Berufserfahrung, das Wissen über KI, den Aufwand der Prüfung und die Art der Erklärung, die das System mitliefert.
Im Großhandel sieht das so aus: Ein Agent liest eine Bestellung per E-Mail und schlägt zwölf Positionen vor. Elf stimmen. In Position sieben steht die Verpackungseinheit statt der Stückzahl. Die Sachbearbeiterin hat an diesem Vormittag vierzig solcher Vorschläge freigegeben, alle waren richtig. Der einundvierzigste geht mit demselben Klick durch. Niemand war nachlässig. Die Oberfläche hat nur nichts gezeigt, woran der Fehler aufgefallen wäre.
Macht ein Mensch in der Schleife das Ergebnis besser?
Gegenüber dem Menschen allein ja, gegenüber dem Besseren von beiden im Schnitt nein. Das ist das Ergebnis der Auswertung von Vaccaro, Almaatouq und Malone vom MIT Center for Collective Intelligence. Sie umfasst 106 Experimente mit 370 Effektgrößen, veröffentlicht zwischen Januar 2020 und Juni 2023.
Zwei Zahlen fassen den Befund. Verglichen mit dem Menschen allein war das Gespann deutlich besser (Hedges’ g = 0,64). Verglichen mit dem Besseren von Mensch oder KI war es schlechter (g = −0,23, 95-Prozent-Konfidenzintervall −0,39 bis −0,07). Die Verluste traten bei Entscheidungsaufgaben auf, also bei der Wahl zwischen festen Möglichkeiten. Bei Aufgaben, in denen Inhalte entstehen, zeigte sich ein Zugewinn, der für sich genommen statistisch nicht gesichert ist.
Entscheidend ist, wer von beiden die Aufgabe besser beherrscht. War der Mensch allein besser als die KI, gewann das Gespann. War die KI besser, verlor es. Die Autoren nennen ein Beispiel aus einer der ausgewerteten Arbeiten. Beim Erkennen gefälschter Hotelbewertungen erreichte die KI 73 Prozent, der Mensch 55 Prozent, beide zusammen 69 Prozent. Beim Bestimmen von Vogelarten lag die KI ebenfalls bei 73 Prozent, der Mensch bei 81 Prozent, das Gespann bei 90 Prozent. Die Erklärung der Autoren: Wer die Aufgabe selbst gut kann, erkennt auch besser, wann er dem Vorschlag trauen darf.
Bemerkenswert ist ein Nebenbefund. Ob das System eine Erklärung oder einen Sicherheitswert anzeigte, änderte das Ergebnis nicht messbar. Romeo und Conti kommen zu einem ähnlichen Schluss: Erklärungen erhöhen die Akzeptanz eines Systems, verbessern die Entscheidung aber oft nicht. Zu technische oder zu schlichte Erklärungen können falsches Vertrauen sogar stützen, vor allem bei wenig erfahrenen Fachkräften.
Für die Auftragserfassung lässt sich daraus eine Arbeitsteilung ableiten. Das ist unsere Lesart, die Studien haben keinen Großhandel untersucht. Beim Abtippen von Artikelnummern ist eine gut eingestellte Erfassung dem Menschen vermutlich überlegen; dort bringt ein zweiter Blick wenig. Bei Sonderabsprachen, Lieferterminen und der Frage, ob dieser Kunde wirklich 400 Stück meint, weiß der Innendienst mehr als jedes Modell. Dorthin gehört die Aufmerksamkeit der Freigabe.
Was passiert, wenn der Vorschlag falsch ist?
Dann zieht er die Entscheidung mit. Sarah Jabbour und Kollegen von der University of Michigan haben das mit 259 Klinikern in neun US-Bundesstaaten gemessen. Die Teilnehmer entschieden an Fallbeschreibungen über die Behandlung von Patienten mit akuter Atemnot. Ohne KI lag die Trefferquote bei 62 Prozent. Zeigte das System einen falschen Vorschlag, fiel sie auf 50 Prozent.
Die Forscher prüften außerdem eine verbreitete Gegenmaßnahme. Das System hält unsichere Vorschläge zurück und meldet stattdessen, dass es die Entscheidung dem Menschen überlässt. Die Trefferquote erholte sich damit auf 55 Prozent. Der Abstand zum Ausgangswert war statistisch nicht mehr gesichert, ganz geschlossen war er nicht.
Die Art der Fehler blieb verschoben. Ohne KI unterblieben 31 Prozent der nötigen Behandlungen. Mit zurückgehaltenem Vorschlag waren es 42 Prozent. Die Annahme hinter dem Zurückhalten lautet, dass Menschen dann so entscheiden, als gäbe es kein System. Sie traf in dieser Studie nicht zu.
Die Einschränkungen nennen die Autoren selbst. Die Fälle waren Fallbeschreibungen in einer Online-Befragung, im Klinikalltag ist der Druck höher. Die Arbeit ist ein Vorabdruck und betrifft Medizin, keine Warenwirtschaft. Übertragbar ist die Vorsicht: Ein Hinweis „bitte selbst prüfen“ versetzt den Prüfer nicht in den Zustand ohne System. Zählen Sie deshalb zwei Fehlerarten getrennt, die falsch übernommene Position und die Position, die fehlt.
Zeigt die KI selbst an, wann sie unsicher ist?
Ein Sprachmodell nennt auf Wunsch einen Sicherheitswert, verlässlich ist er nicht. Sachin Gupta hat das an 47.837 IT-Tickets in acht Kategorien geprüft, mit vier trainierten Klassifikatoren und vier Sprachmodellen. Jedes der Sprachmodelle überschätzte sich. Eines vergab an jedes Ticket die Sicherheit 1,0 und ordnete 45,9 Prozent richtig zu.
Ein Wert, der bei jedem Fall gleich ist, trennt sichere von unsicheren Fällen nicht. Anders der trainierte Klassifikator in derselben Studie. Mit einer Schwelle von 0,60 leitete er 70,5 Prozent der Tickets selbst weiter und lag dabei zu 95,0 Prozent richtig. Der Anteil falsch zugeordneter Tickets sank von 15,3 auf 3,5 Prozent. Die Schwelle wurde auf zurückgelegten Daten gewählt und danach einmal an frischen Daten geprüft.
Auch diese Arbeit hat Grenzen. Sie stammt von einem einzelnen Autor und nutzt einen einzigen öffentlichen Datensatz. Die Sprachmodelle sahen nur die Namen der Kategorien und höchstens drei Beispiele je Kategorie, die Klassifikatoren wurden auf den Trainingsdaten des Datensatzes trainiert. Ein Leistungsvergleich der Modelle ist das nicht. Belegt ist der engere Punkt: Der selbst genannte Sicherheitswert eines Sprachmodells taugt ohne Messung nicht als Schwelle.
Agenten halten zudem selten von selbst an. Ein Team der University of Washington und der University of Leeds hat 13 Sprachmodelle als Agenten an mehr als 28.000 Aufgaben geprüft, darunter Einkäufe in einem Testshop, bei denen kein Artikel zur Vorgabe passte (Luo, Wen und Wang, arXiv 2606.28733, angenommen für die NeurIPS 2026). In der Shop-Umgebung brach das beste System nur in 32,6 Prozent der Fälle rechtzeitig ab, in denen ein Abbruch angezeigt war. Nach weiteren, unnötigen Schritten waren es 84,2 Prozent. Größere Modelle waren darin nicht durchweg besser.
Das Signal für Unsicherheit muss deshalb von außen kommen. Im Großhandel liegt es in den Stammdaten: Gibt es die Artikelnummer? Passt die Menge zur Verpackungseinheit? Liegt der Preis im Band der letzten Bestellungen dieses Kunden? Solche Abgleiche sind einfache Regeln, und sie setzen einen sauberen Zugriff auf das Warenwirtschaftssystem voraus. Den beschreibt der Beitrag zur ERP-Anbindung für KI-Agenten.
Ab welcher Sicherheit darf ein Vorgang ohne Freigabe durchlaufen?
Sobald der erwartete Schaden eines Fehlers kleiner ist als der Aufwand der Prüfung. Gupta leitet dafür eine Rechenregel her. Kostet eine Prüfung eine Einheit und ein Fehler fünf, lohnt der Durchlauf ab einer Trefferwahrscheinlichkeit von 80 Prozent. Allgemein: Schwelle = 1 − Prüfkosten ÷ Fehlerkosten.
Die folgende Tabelle wendet diese Regel auf sechs Kostenverhältnisse an. Sie ist gerechnet und beruht auf keiner Erhebung. Die Beispiele in der rechten Spalte sind unsere Einordnung für das Gespräch zwischen Fachabteilung und IT; Ihr eigenes Kostenverhältnis müssen Sie selbst bestimmen.
| Ein Fehler kostet so viel wie … | Schwelle für den Durchlauf | Beispiel zur Einordnung |
|---|---|---|
| 2 Prüfungen | 50 % | E-Mail landet im falschen Postfach und wird weitergereicht |
| 5 Prüfungen | 80 % | Rückfrage an den Kunden wegen einer unklaren Position |
| 10 Prüfungen | 90 % | Auftragsbestätigung muss korrigiert neu verschickt werden |
| 20 Prüfungen | 95 % | Falscher Artikel wird kommissioniert und kommt zurück |
| 50 Prüfungen | 98 % | Falsche Menge einer Sonderanfertigung wird bestellt |
| 100 Prüfungen | 99 % | Zahlung geht an eine geänderte, ungeprüfte Bankverbindung |
Die Regel hat zwei Voraussetzungen. Erstens muss der Sicherheitswert stimmen. Von allen Vorgängen, die das System mit 95 Prozent einstuft, müssen an zurückgelegten Fällen tatsächlich 95 von 100 richtig sein. Wie die Studie zeigt, erfüllt die Selbstauskunft eines Sprachmodells das nicht. Brauchbar wird der Wert erst, wenn er aus Abgleichen und gemessenen Trefferquoten je Vorgangsart entsteht.
Zweitens unterstellt die Regel, dass die Prüfung den Fehler findet. Findet sie nur einen Teil, ist die Freigabe weniger wert als angenommen, und die Schwelle verschiebt sich. Diese Erkennungsquote kennt kaum ein Betrieb. Sie lässt sich aber messen.
Wie messen Sie, ob Ihre Freigabe wirklich prüft?
Mit eingestreuten Testfehlern. Sie mischen Vorgänge mit einem bekannten Fehler unter die echten Freigaben und zählen, wie viele den Prüfern auffallen. Das Verfahren ist ein eigenes Arbeitswerkzeug und setzt voraus, dass Testvorgänge technisch nicht gebucht oder versendet werden können.
Bauen Sie die Fehler so, wie sie im Betrieb vorkommen: Verpackungseinheit statt Stückzahl, ein ähnlicher Artikel aus derselben Gruppe, ein Preis aus der alten Liste, eine vertauschte Lieferadresse. Informieren Sie das Team vorab über das Verfahren, ohne die einzelnen Fälle zu nennen. Gemessen werden Oberfläche und Ablauf; einzelne Mitarbeiter werden nicht bewertet. In Betrieben mit Betriebsrat gehört er an den Tisch, bevor Sie beginnen.
Wie belastbar das Ergebnis ist, hängt von der Zahl der Testfehler ab. Die Tabelle zeigt das 95-Prozent-Konfidenzintervall der wahren Erkennungsquote, berechnet nach Clopper und Pearson.
| Eingestreute Testfehler | Davon gefunden | Wahre Erkennungsquote liegt zwischen |
|---|---|---|
| 20 | 20 | 83 % und 100 % |
| 20 | 18 | 68 % und 99 % |
| 20 | 16 | 56 % und 94 % |
| 20 | 12 | 36 % und 81 % |
| 50 | 50 | 93 % und 100 % |
| 50 | 45 | 78 % und 97 % |
| 50 | 40 | 66 % und 90 % |
| 50 | 30 | 45 % und 74 % |
Zwanzig Testfehler reichen für eine grobe Aussage. Finden die Prüfer zwölf, liegt die Quote mit hoher Sicherheit unter 81 Prozent, und die Freigabe trägt als alleinige Sicherung nicht. Finden sie alle zwanzig, sind 83 Prozent weiterhin nicht ausgeschlossen. Für die Vorgänge, die ohne Freigabe durchlaufen, gilt eine ähnliche Faustregel: Bleibt eine Stichprobe von 100 Vorgängen fehlerfrei, lässt sich mit 95 Prozent Sicherheit nur eine Fehlerquote oberhalb von knapp 3 Prozent ausschließen, bei 300 Vorgängen oberhalb von 1 Prozent.
Fünf Regeln für eine Freigabe, die Fehler findet
Die Regeln sind unsere Ableitung aus den genannten Quellen und kein geprüftes Verfahren. Sie ergänzen die Liste im Beitrag zur KI-Governance im Mittelstand, die beschreibt, was eine Freigabemaske zeigen sollte.
- Abweichungen nach vorn. Die Maske zeigt zuerst, was vom Stamm, von der letzten Bestellung oder vom Preisband abweicht. Zwölf unauffällige Positionen brauchen keine zwölf Blicke.
- Aufwand dort, wo der Schaden entsteht. Romeo und Conti halten fest, dass höherer Prüfaufwand die Nachlässigkeit gegenüber falschen Empfehlungen senkt. Verlangen Sie bei Menge, Preis und Lieferadresse eine eigene Bestätigung, wenn ein Abgleich anschlägt. Ein Sammelklick für den ganzen Beleg leistet das nicht.
- Schwelle je Vorgangsart. Legen Sie das Kostenverhältnis für jede Vorgangsart fest, wählen Sie die Schwelle auf zurückgelegten Fällen und prüfen Sie sie einmal an frischen. Ändern Sie sie danach nur mit Protokoll.
- Zwei Fehlerarten zählen. Führen Sie falsch übernommene und fehlende Positionen getrennt. Die Studie von Jabbour und Kollegen zeigt, dass eine Gegenmaßnahme die eine Art senken und die andere erhöhen kann.
- Freigabequote lesen. Übernimmt ein Team über Wochen jeden Vorschlag unverändert, gibt es zwei Erklärungen: Die Strecke ist reif für den Durchlauf, oder niemand prüft mehr. Die Testfehler zeigen, welche zutrifft.
Derselbe Effekt wirkt in der anderen Richtung. Wo Disponenten Vorschläge aus Gewohnheit überschreiben, geht der Nutzen ebenso verloren; das behandelt der Beitrag zu übersteuerten Bestellvorschlägen.
Was verlangt die KI-Verordnung zur menschlichen Aufsicht?
Art. 14 der Verordnung (EU) 2024/1689 gilt für Hochrisiko-KI-Systeme. Er verlangt, dass die beaufsichtigenden Personen Fähigkeiten und Grenzen des Systems verstehen, sich des Automatisierungsbias bewusst bleiben, die Ausgabe richtig deuten und sie verwerfen können. Nach Art. 26 Abs. 2 übertragen Betreiber die Aufsicht an Personen mit der nötigen Kompetenz, Ausbildung und Befugnis.
Auftragserfassung, Rechnungsprüfung und Angebotsentwürfe im Großhandel fallen nach unserer Einordnung in der Regel nicht unter die Hochrisiko-Kategorien. Welche Anwendungen dazugehören und welche Fristen gelten, steht im Beitrag zu EU AI Act und DSGVO bei KI-Agenten. Die Pflicht zur KI-Kompetenz nach Art. 4 gilt unabhängig von der Risikoklasse.
Als Maßstab taugt Art. 14 auch außerhalb des Pflichtbereichs. Der Gesetzgeber hat mit dem Automatisierungsbias einen Befund aus der Psychologie in den Verordnungstext geschrieben. Wer eine Freigabe als Sicherung ausweist, sollte zeigen können, dass sie Fehler findet. Dieser Abschnitt ersetzt keine Rechtsberatung.
Häufige Fragen
Was ist Automation Bias? Die Neigung, den Vorschlag eines automatischen Systems zu übernehmen, ohne ihn ausreichend zu prüfen. Die KI-Verordnung der EU beschreibt ihn in Art. 14 als mögliche Neigung zu einem automatischen oder übermäßigen Vertrauen in die Ausgabe eines KI-Systems und nennt ihn Automatisierungsbias.
Reicht es, wenn ein Mitarbeiter jeden KI-Vorschlag freigibt? Als alleinige Sicherung nein. Eine Auswertung von 106 Experimenten in Nature Human Behaviour fand, dass Mensch und KI zusammen im Schnitt schlechter abschneiden als der Bessere von beiden allein. In einer Studie mit 259 Klinikern sank die Trefferquote bei falschen KI-Vorschlägen von 62 auf 50 Prozent. Die Freigabe braucht Abgleiche und eine eigene Messung.
Was verlangt die KI-Verordnung zur menschlichen Aufsicht? Art. 14 gilt für Hochrisiko-KI-Systeme. Die beaufsichtigenden Personen müssen Fähigkeiten und Grenzen des Systems verstehen, sich des Automatisierungsbias bewusst bleiben und die Ausgabe verwerfen können. Nach Art. 26 Abs. 2 übertragen Betreiber die Aufsicht an Personen mit Kompetenz, Ausbildung und Befugnis.
Kann ein Sprachmodell selbst angeben, wie sicher es ist? Es nennt einen Wert, aber verlassen können Sie sich darauf nicht. In einer Studie zur Zuordnung von 47.837 IT-Tickets gab ein Modell jedem Ticket die Sicherheit 1,0 und lag bei 45,9 Prozent Treffern. Belastbarer sind Prüfungen außerhalb des Modells, etwa der Abgleich gegen Artikelstamm, Preisliste und Bestellhistorie.
Ab wann darf ein Vorgang ohne Freigabe durchlaufen? Wenn der erwartete Schaden eines Fehlers kleiner ist als der Aufwand der Prüfung. Als Rechenregel: Die Sicherheit muss mindestens 1 minus Prüfkosten geteilt durch Fehlerkosten betragen. Ist ein Fehler 20-mal so teuer wie eine Prüfung, liegt die Schwelle bei 95 Prozent. Die Sicherheit muss an eigenen Fällen gemessen sein.
Wie misst man, ob eine Freigabe Fehler findet? Mit eingestreuten Testfehlern. Sie mischen Vorgänge mit bekannten Fehlern unter die Freigaben und zählen, wie viele auffallen. Bei 20 Testfehlern und 16 Funden liegt die Erkennungsquote rechnerisch zwischen 56 und 94 Prozent. Für eine engere Aussage brauchen Sie mehr Testfälle.
Wo Sie anfangen, wenn Sie heute starten möchten
Nehmen Sie die Strecke, auf der heute am meisten freigegeben wird. Bauen Sie zwanzig Testfehler aus echten Fehlerbildern der letzten Monate und streuen Sie sie über zwei Wochen ein. Zählen Sie die Funde und lesen Sie das Ergebnis in der Tabelle ab. Mit dieser einen Zahl entscheiden Sie, ob zuerst die Maske, die Abgleiche oder die Schwelle an die Reihe kommen.
Wie eine Freigabe mit Abgleich gegen Artikelstamm und Preise in der Auftragserfassung aussieht, steht auf der Seite Auftragserfassung automatisieren. Wenn Sie die Messung für Ihre Strecke aufsetzen möchten, vereinbaren Sie ein Erstgespräch. Den größeren Rahmen gibt der Überblick zu KI-Agenten im Mittelstand.
Quellen: Vaccaro, Almaatouq und Malone, „When combinations of humans and AI are useful: A systematic review and meta-analysis“, Nature Human Behaviour 8, 2293–2303, veröffentlicht am 28.10.2024; Jabbour et al., „Selective Prediction Reduces the Negative Effects of Automation Bias Overall but Increases False Negatives“, arXiv 2508.07617, gelesen in der zweiten Fassung vom 11.08.2026; Gupta, „Cost-Aware Abstention for LLM-Based IT Ticket Classification“, arXiv 2610.31657, 22.10.2026, angenommen für die IEEE ICTAI 2026; Luo, Wen und Wang, „Agentic Abstention: Do Agents Know When to Stop Instead of Act?“, arXiv 2606.28733, 27.06.2026; Romeo und Conti, „Exploring automation bias in human–AI collaboration: a review and implications for explainable AI“, AI & Society 41, 259–278, veröffentlicht am 03.07.2025; Verordnung (EU) 2024/1689, Art. 14 und Art. 26, deutsche Fassung im Amtsblatt. Vier Arbeiten und der Verordnungstext wurden im Original gelesen. Der Übersichtsartikel von Romeo und Conti war zum Zeitpunkt der Recherche nur in der Kurzfassung des Verlags zugänglich; alle Aussagen dazu stammen aus dieser Kurzfassung. Die Studie von Jabbour und Kollegen ist ein Vorabdruck aus der Medizin mit Fallbeschreibungen; die Zahlen der ersten Fassung weichen ab. Die Studie von Gupta stammt von einem einzelnen Autor und nutzt einen öffentlichen Datensatz mit beispielhaften Kosten. Keine der Arbeiten untersucht den Großhandel; die Übertragung ist unsere Einordnung. Das Beispiel mit zwölf Positionen ist erdacht. Die Schwellentabelle und die Tabelle der Konfidenzintervalle sind gerechnet (Clopper-Pearson, zweiseitig, 95 Prozent); die Beispiele zu den Kostenverhältnissen, die fünf Regeln und das Verfahren mit Testfehlern sind eigene Arbeitswerkzeuge und beruhen nicht auf einer Erhebung oder einem Kundenprojekt. Zuletzt aktualisiert: 20.11.2026.