KI lokal betreiben: Wann ein kleines Sprachmodell im Unternehmen reicht
66 Prozent der Unternehmen, die KI einsetzen, nennen die Anforderungen an den Datenschutz als Hemmnis. 45 Prozent sorgen sich, dass Unternehmensdaten in falsche Hände gelangen (Bitkom, 14.09.2026, 603 Unternehmen). Daraus entsteht in vielen Betrieben dieselbe Frage: Lässt sich ein KI-Agent auch mit einem Modell betreiben, das im eigenen Netz läuft?
Die Antwort hängt an der Aufgabe. Dieser Beitrag stützt sich auf zwei Fachartikel und einen eigenen Versuch. Ein Hinweis vorab: Der wichtigste der beiden Fachartikel stammt von NVIDIA Research. NVIDIA verkauft die Hardware, auf der lokale Modelle laufen. Lesen Sie die Kostenargumente entsprechend kritisch; wir nennen deshalb auch die Gegenargumente, die die Autoren selbst aufführen.
Worum es geht: die Kurzfassung
- Klein heißt: läuft auf einem einzelnen Gerät. Ein Team von NVIDIA Research zählt für 2025 Modelle unter 10 Milliarden Parametern dazu (Belcak et al., arXiv 2506.02153).
- Agenten bestehen aus vielen engen Teilaufgaben. Für drei offene Agenten-Systeme schätzen die Autoren, dass kleine Modelle 40 bis 70 Prozent der Modellaufrufe übernehmen könnten. Das ist eine Schätzung, keine Messung.
- Fakten gehören ins Nachschlagen, nicht ins Modell. In unserem Versuch lernte ein Modell mit 1,1 Milliarden Parametern den Satzbau eines Handbuchs und nannte trotzdem meist die falsche Stückzahl. In einer Studie sank die Halluzinationsrate eines lokalen Modells durch RAG von 8 auf 0 Prozent (Wada et al., npj Digital Medicine, 02.07.2025).
- Große Cloud-Modelle bleiben bei offenen Fällen vorn. In derselben Studie lagen drei Cloud-Modelle im Urteil des Radiologen vor dem lokalen Modell.
- Lokal ist keine Abkürzung beim Datenschutz und nicht von selbst billiger. 54 Prozent der KI-Anwender nennen schwer zu kalkulierende Kosten als Hemmnis (Bitkom, 14.09.2026).
Was ist ein kleines Sprachmodell?
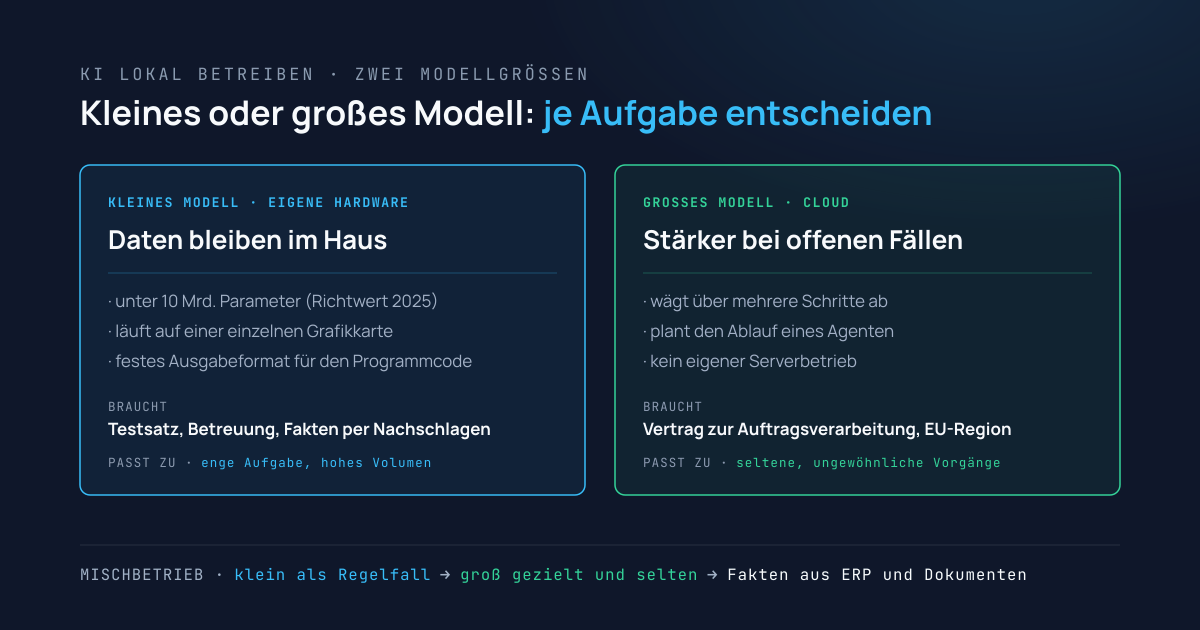
Ein kleines Sprachmodell (Small Language Model, SLM) passt auf ein einzelnes handelsübliches Gerät und antwortet dort schnell genug, um einen Nutzer zu bedienen. So definieren es Peter Belcak und Kollegen von NVIDIA Research. Als Richtwert für 2025 nennen sie weniger als 10 Milliarden Parameter. Alles darüber gilt in ihrer Einteilung als großes Modell.
Die Definition ist absichtlich an den Betrieb gebunden und an keine feste Zahl. Was heute als klein gilt, wächst mit der Hardware. Beispiele aus dem Artikel sind Phi-3 small von Microsoft mit 7 Milliarden Parametern und die SmolLM2-Reihe von Hugging Face. Deren größtes Modell hat 1,7 Milliarden Parameter (Allal et al., arXiv 2502.02737, 04.02.2025). Solche Modelle sind offen verfügbar. Sie laden die Gewichte herunter und betreiben sie auf eigener Hardware, ohne dass eine Anfrage das Haus verlässt.
Warum reicht für viele Agenten-Aufgaben ein kleines Modell?
Weil ein Agent seine Arbeit in enge Schritte zerlegt. Belcak und Kollegen beschreiben, dass Sprachmodelle in Agenten-Systemen wenige spezialisierte Aufgaben wiederholt und mit geringer Abweichung ausführen. Für solche Aufrufe halten sie kleine Modelle für ausreichend leistungsfähig, im Betrieb passender und sparsamer.
Ein Beispiel aus dem Großhandel: Ein Agent für die Auftragserfassung liest eine E-Mail, erkennt die Absicht, zieht Positionen in ein festes Format und gleicht sie mit dem Artikelstamm ab. Keiner dieser Schritte verlangt Allgemeinwissen über die Welt. Verlangt wird ein immer gleiches Ausgabeformat, das der nachgelagerte Programmcode verarbeiten kann. Genau dort sehen die Autoren kleine, auf ein Format festgelegte Modelle im Vorteil.
Im Anhang prüfen sie drei verbreitete offene Agenten-Systeme. Ihr Ergebnis: Rund 60 Prozent der Modellaufrufe bei MetaGPT, 40 Prozent bei Open Operator und 70 Prozent bei Cradle ließen sich durch spezialisierte kleine Modelle erledigen. Die Zahlen sind Einschätzungen der Autoren. Gemessen wurde der Tausch nicht.
Der Artikel ist ein Positionspapier, und er nennt seine Grenzen selbst. Für Schritte, die offene Gespräche oder allgemeines Abwägen verlangen, empfehlen die Autoren gemischte Systeme: kleine Modelle als Regelfall, ein großes Modell gezielt und selten. Für die Aufgaben in der Tabelle weiter unten läuft es auf diese Mischung hinaus.
Was lernt ein kleines Modell nicht? Unser Versuch
Verlässliche Fakten. Im November 2026 haben wir ein offenes Modell mit 1,1 Milliarden Parametern auf einer Workstation mit einem englischsprachigen Übungshandbuch nachtrainiert und danach eine Zahl aus diesem Handbuch abgefragt. Das Modell übernahm den Satzbau des Handbuchs. Die richtige Zahl nannte es in einer von drei Antworten.
Der Aufbau: Modell TinyLlama, Grafikkarte NVIDIA RTX 5080 mit 16 GB Speicher, 42 Absätze Trainingstext mit im Schnitt 71 Tokens. Trainiert wurde mit dem Verfahren LoRA, das nur kleine Zusatzmatrizen anpasst. Das waren 1.126.400 Parameter oder 0,10 Prozent des Modells. 30 Trainingsschritte dauerten 19 Sekunden. Die Testfrage lautete, wie viele Stück eine Verpackungseinheit eines bestimmten Artikels enthält. Im Handbuch steht: sechs.
| Lauf | Antworten auf die Testfrage | Richtig |
|---|---|---|
| 5 Durchgänge durch den Text (30 Schritte) | Gegenfragen und erfundene Angaben | 0 von 3 |
| 30 Durchgänge (180 Schritte) | Satzbau des Handbuchs; einmal „six“, zweimal „eight“ | 1 von 3 |
| 30 Durchgänge mit Konfigurationsfehler | 24, 20, 28, 15, 1, 24, 1, 40 | 0 von 8 |
Die dritte Zeile ist die lehrreichste. In diesem Lauf gingen die Fülltokens am Ende jedes Absatzes in den Fehlerwert ein. Der Fehlerwert des Trainings fiel auf 0,2 und sah damit besser aus als im sauberen Lauf mit 0,86. Die Antworten waren durchweg falsch. Wer nur auf die Trainingskurve schaut, hält ein unbrauchbares Modell für ein gutes. Ohne einen Testsatz mit bekannten richtigen Antworten lässt sich ein nachtrainiertes Modell nicht beurteilen.
Das ist ein Werkstattversuch mit einer Frage und wenigen Stichproben, keine Studie. Er deckt sich aber mit der Forschung. Wada und Kollegen haben ein lokal betreibbares Modell mit 11 Milliarden Parametern (Llama 3.2) an 100 erdachten Beratungsfällen zu Kontrastmitteln in der Radiologie geprüft. Ohne Zugriff auf die Leitlinien enthielten 8 Prozent der Antworten Halluzinationen, etwa falsche Dosierungen. Mit RAG, also dem Nachschlagen in den hinterlegten Dokumenten, waren es 0 Prozent. Der mittlere Rang im Urteil des Radiologen verbesserte sich von 4,80 auf 3,54 bei fünf verglichenen Systemen.
Für Ihren Betrieb folgt daraus eine Arbeitsteilung. Das kleine Modell formuliert, sortiert und füllt Formate. Preise, Stückzahlen und Konditionen liest das System aus dem ERP oder aus Ihren Dokumenten. Wie das Nachschlagen funktioniert, beschreibt der Beitrag RAG: KI mit Ihren eigenen Daten; wann sich Nachtrainieren überhaupt lohnt, klärt RAG oder Fine-Tuning.
Dieselbe Studie zeigt die Grenze. Die drei Cloud-Modelle im Vergleich lagen im Urteil des Radiologen vor dem lokalen Modell, auch nach der Verbesserung durch RAG. Der Abstand zum schwächsten Cloud-Modell schrumpfte auf 3,54 gegenüber 3,21. Die Autoren schränken selbst ein: Die Fälle waren konstruiert, und bewertet hat ein einzelner Radiologe.
Für welche Aufgaben im Großhandel passt ein lokales kleines Modell?
Für Aufgaben, die eng umrissen sind, oft anfallen und ein festes Ergebnis haben. Die Tabelle ist ein eigenes Arbeitswerkzeug für das Gespräch zwischen IT-Leitung und Fachabteilung und beruht nicht auf einer Erhebung.
| Aufgabe | Passendes Modell | Begründung |
|---|---|---|
| Posteingang in feste Kategorien sortieren | klein, lokal | Enge Aufgabe, hohes Volumen, E-Mails enthalten Kundendaten |
| Bestellpositionen aus E-Mail oder PDF in ein festes Format bringen | klein, lokal, mit Abgleich gegen den Artikelstamm | Format ist fest, die Prüfung gegen das ERP fängt Fehler ab |
| Auskunft aus Datenblättern und Handbüchern | klein, lokal, mit RAG | Fakten kommen aus dem Dokument, das Modell formuliert |
| Freitext-Position einem Artikel zuordnen | Suche im Artikelstamm, kleines Modell für die Auswahl | Bekannte Zuordnungen sind sicherer als jede Schätzung |
| Ungewöhnliche Reklamation mit mehreren Beteiligten klären | groß, Entwurf für den Sachbearbeiter | Offener Fall, Abwägung über mehrere Schritte |
| Ablauf eines Agenten über viele Schritte planen | groß für die Planung, klein für die Teilschritte | Mischbetrieb, wie ihn Belcak und Kollegen beschreiben |
Die ersten beiden Zeilen eignen sich als Einstieg, weil dort die Beispiele für einen Testsatz schon im Postfach und im ERP liegen. Die Aufgabe selbst beschreibt der Beitrag zur Klassifikation des Posteingangs. Der Abgleich in Zeile zwei setzt einen sauberen Zugriff auf das Warenwirtschaftssystem voraus, siehe ERP-Anbindung für KI-Agenten.
Welche Hardware brauchen Sie, um KI lokal zu betreiben?
Das hängt von zwei Größen ab: der Modellgröße und der Zahl gleichzeitiger Anfragen. Für den Speicher gilt eine einfache Rechenregel. Parameterzahl mal Bytes pro Parameter ergibt den Platz, den die Gewichte auf der Grafikkarte belegen. Dazu kommt Arbeitsspeicher für die laufende Anfrage.
Wie viele Bytes ein Parameter belegt, legen Sie über die Genauigkeit fest. Üblich sind 16 Bit (2 Bytes). Durch Quantisierung lässt sich ein Modell auf 8 oder 4 Bit verkleinern, mit einem gewissen Verlust an Qualität. Als Rechenbeispiel:
| Modellgröße | 16 Bit | 8 Bit | 4 Bit |
|---|---|---|---|
| 1,1 Mrd. Parameter | 2,2 GB | 1,1 GB | 0,6 GB |
| 9 Mrd. Parameter | 18 GB | 9 GB | 4,5 GB |
| 11 Mrd. Parameter | 22 GB | 11 GB | 5,5 GB |
Die Tabelle ist gerechnet, nicht gemessen, und zeigt nur die Gewichte. Zwei Messpunkte zur Einordnung: Unser vollständiges Nachtraining des Modells mit 1,1 Milliarden Parametern belegte in der Spitze rund 11,5 GB der 16-GB-Karte. Training braucht ein Vielfaches des reinen Betriebs. Wada und Kollegen nutzten für die lokale Gegenprobe ihres Modells mit 11 Milliarden Parametern eine Workstation mit einer Grafikkarte mit 48 GB Speicher.
Die Definition von Belcak und Kollegen gilt für einen Nutzer. Soll eine Abteilung gleichzeitig arbeiten, zählt neben dem Speicher der Durchsatz, also wie viele Anfragen der Server pro Minute beantwortet. Messen Sie das mit Ihren eigenen Vorgängen, bevor Sie Hardware bestellen. Ein Probelauf liefert dafür belastbarere Zahlen als jedes Datenblatt.
Ist lokale KI günstiger als ein Cloud-Modell?
Je Aufruf oft ja, in der Gesamtrechnung nicht zwingend. Belcak und Kollegen beziffern den Betrieb eines Modells mit 7 Milliarden Parametern als 10- bis 30-mal sparsamer als den eines Modells mit 70 bis 175 Milliarden. Gemessen ist das an Antwortzeit, Energie und Rechenoperationen. Das Nachtrainieren kleiner Modelle koste wenige GPU-Stunden.
Die Gegenrechnung steht im selben Artikel. Die Kosten für den Aufbau der eigenen Infrastruktur und für die Fachleute, die sie betreuen, fehlen laut den Autoren häufig in solchen Vergleichen. Ein spezialisiertes Modell lässt sich außerdem schwerer gleichmäßig auslasten als ein zentraler Dienst. Ihr Urteil zu der Frage, ob große Anbieter durch ihre Größe dauerhaft billiger bleiben: Das sei offen und hänge stark vom Einzelfall ab.
Für die eigene Rechnung helfen drei Kostenblöcke. Erstens die Hardware mit ihrer Abschreibung. Zweitens der Betrieb: Aktualisierungen, Überwachung und die Frage, wer bei einem Ausfall einspringt. Drittens die Pflege des Modells mit Testsatz und Modellwechsel. In der Bitkom-Befragung nennen 51 Prozent der KI-Anwender die Infrastruktur als großen Kostenpunkt, Lizenzen dagegen nur 21 Prozent. Wer nur wenige Vorgänge am Tag hat, lastet eigene Hardware kaum aus und rechnet mit einem Cloud-Modell in einer EU-Region einfacher. Wie Sie den Nutzen gegenrechnen, steht im Beitrag KI-ROI messen.
Ist eine lokal betriebene KI automatisch DSGVO-konform?
Nein. Der lokale Betrieb nimmt einen Schritt aus der Kette: Die Anfrage geht an keinen Modellanbieter. Damit entfallen für diesen Schritt der Vertrag zur Auftragsverarbeitung nach Art. 28 DSGVO und die Prüfung einer Übermittlung in ein Drittland nach Art. 44 ff. DSGVO. Die übrigen Pflichten bleiben bei Ihnen.
Dazu gehören die Rechtsgrundlage für die Verarbeitung, die Zweckbindung, ein Löschkonzept und die Sicherheit der Verarbeitung nach Art. 32 DSGVO. Ein Server im eigenen Keller, auf den jeder im Netz zugreifen darf, steht datenschutzrechtlich schlechter da als ein vertraglich sauber geregelter Dienst in einer EU-Region. Berechtigungen müssen an den Dokumenten hängen, bevor ein RAG-System sie durchsucht. Protokolle der Anfragen enthalten oft personenbezogene Daten und brauchen eine eigene Löschfrist.
Die Pflichten aus dem EU AI Act hängen ebenfalls nicht am Standort des Servers. Was für Betreiber gilt, ordnet der Beitrag zu EU AI Act und DSGVO bei KI-Agenten ein. Dieser Abschnitt ersetzt keine Rechtsberatung; beziehen Sie Ihre Datenschutzbeauftragte oder Ihren Datenschutzbeauftragten früh ein.
Fünf Fragen: lokal, Cloud oder gemischt?
Entscheiden Sie je Aufgabe. Die fünf Fragen sind ein eigenes Arbeitswerkzeug und lassen sich in einer Stunde mit IT-Leitung und Fachabteilung durchgehen.
- Welche Daten sieht das Modell? Kundenkorrespondenz, Einkaufskonditionen und Personaldaten sprechen für den lokalen Betrieb oder einen geregelten Dienst in der EU. Öffentliche Produkttexte tun es nicht.
- Wie eng ist die Aufgabe? Feste Kategorien und feste Formate liegen einem kleinen Modell. Offene Rückfragen und Abwägungen über mehrere Schritte gehören zu einem großen.
- Wie viele Vorgänge fallen an? Eigene Hardware rechnet sich über die Auslastung. Zählen Sie die Vorgänge pro Tag, bevor Sie Angebote einholen.
- Wer betreibt den Server? Benennen Sie die Person, die Aktualisierungen einspielt und bei einem Ausfall reagiert. Fehlt sie, ist ein betreuter Dienst die ehrlichere Wahl.
- Gibt es einen Testsatz? 100 bis 200 zurückgelegte Fälle mit bekannter richtiger Antwort reichen als Größenordnung für einen ersten Vergleich; die Zahl ist eine Arbeitsannahme. Lassen Sie ein kleines lokales und ein großes Modell gegen denselben Satz laufen.
In vielen Fällen endet die Runde bei einem Mischbetrieb. Die Aufgaben mit sensiblen Daten und hohem Volumen laufen lokal. Die seltenen offenen Fälle gehen an ein großes Modell oder direkt an den Sachbearbeiter. Regeln dafür gehören in Ihre KI-Governance, sonst entscheidet jeder Mitarbeiter selbst, welches Werkzeug er nutzt.
Häufige Fragen
Was ist ein kleines Sprachmodell? Ein Sprachmodell, das auf einem einzelnen handelsüblichen Gerät läuft und dort schnell genug antwortet, um einen Nutzer zu bedienen. So definiert es ein Team von NVIDIA Research. Als Richtwert nennen die Autoren für das Jahr 2025 Modelle mit weniger als 10 Milliarden Parametern.
Kann man KI ohne Cloud im eigenen Unternehmen betreiben? Ja. Offene Sprachmodelle laufen auf einem eigenen Server oder einer Workstation mit Grafikkarte, ohne dass Daten das Haus verlassen. In unserem Versuch lief ein Modell mit 1,1 Milliarden Parametern auf einer Grafikkarte mit 16 GB Speicher. Für mehrere gleichzeitige Nutzer und größere Modelle steigt der Bedarf.
Welche Hardware braucht man, um KI lokal zu betreiben? Das hängt von der Modellgröße und der Zahl gleichzeitiger Anfragen ab. Als Rechenregel gilt: Parameterzahl mal Bytes pro Parameter. Ein Modell mit 9 Milliarden Parametern belegt bei 4 Bit rund 4,5 GB Grafikspeicher, bei 16 Bit rund 18 GB, jeweils zuzüglich Arbeitsspeicher für die Anfrage. Nachtrainieren braucht deutlich mehr als der reine Betrieb.
Ist eine lokal betriebene KI automatisch DSGVO-konform? Nein. Der lokale Betrieb erspart die Weitergabe an einen Modellanbieter und damit Auftragsverarbeitung und Drittlandtransfer für diesen Schritt. Rechtsgrundlage, Zweckbindung, Löschkonzept, Zugriffsrechte und die Sicherheit der Verarbeitung nach Art. 32 DSGVO bleiben Ihre Aufgabe. Auch die Pflichten aus dem EU AI Act hängen nicht am Standort des Servers.
Sind kleine Sprachmodelle so gut wie ChatGPT? Für offene Gespräche und mehrstufige Abwägungen nein. In einer Studie in npj Digital Medicine lagen drei Cloud-Modelle in 100 Testfällen vor dem lokalen Modell, auch nachdem es mit RAG verbessert wurde. Für enge, wiederkehrende Aufgaben mit festem Ausgabeformat ist der Abstand kleiner; dort entscheidet ein eigener Testsatz.
Ist lokale KI günstiger als ein Cloud-Modell? Je Aufruf oft ja, in der Gesamtrechnung nicht zwingend. NVIDIA Research beziffert den Betrieb eines Modells mit 7 Milliarden Parametern als 10- bis 30-mal sparsamer als den eines Modells mit 70 bis 175 Milliarden. Dieselben Autoren räumen ein, dass Aufbau und Betreuung der eigenen Infrastruktur in solchen Rechnungen oft fehlen.
Wo Sie anfangen, wenn Sie heute starten möchten
Wählen Sie eine einzige Aufgabe aus den ersten beiden Zeilen der Tabelle und legen Sie 100 erledigte Fälle mit ihrem richtigen Ergebnis zurück. Lassen Sie ein offenes kleines Modell auf einer vorhandenen Workstation gegen diesen Satz laufen, daneben ein großes Modell mit denselben Fällen in anonymisierter Form. Der Vergleich braucht keine neue Hardware und beantwortet die Frage, ob lokal für diese Aufgabe genügt.
Wenn Sie den Vergleich für Ihre Auftragserfassung aufsetzen möchten, finden Sie den Rahmen dafür auf der Seite Auftragserfassung automatisieren. Oder Sie vereinbaren ein Erstgespräch. Den größeren Rahmen gibt der Überblick zu KI-Agenten im Mittelstand.
Quellen: Belcak et al., „Small Language Models are the Future of Agentic AI“, arXiv 2506.02153, erste Fassung vom 02.06.2025, gelesen in der Fassung vom 22.09.2026; Wada et al., „Retrieval-augmented generation elevates local LLM quality in radiology contrast media consultation“, npj Digital Medicine 8, 395, veröffentlicht am 02.07.2025; Allal et al., „SmolLM2: When Smol Goes Big“, arXiv 2502.02737, 04.02.2025; Bitkom-Presseinformation „Erstmals nutzt die Mehrheit der Unternehmen KI“ vom 14.09.2026 (603 Unternehmen ab 20 Beschäftigten). Der Artikel von Belcak und Kollegen ist ein Positionspapier von NVIDIA Research; die Anteile ersetzbarer Modellaufrufe sind Schätzungen der Autoren. Die Studie von Wada und Kollegen arbeitet mit erdachten Fällen aus der Radiologie und einem bewertenden Radiologen; das lokale Modell lief für den Hauptvergleich über eine gehostete Schnittstelle und wurde zusätzlich auf eigener Hardware geprüft. Der eigene Versuch (November 2026, TinyLlama mit 1,1 Milliarden Parametern, 42 Absätze, eine Testfrage, drei bzw. acht Stichproben) ist ein Werkstattversuch und kein Kundenprojekt. Die Speichertabelle ist gerechnet. Die Aufgabentabelle, die fünf Fragen und die Größe des Testsatzes sind eigene Arbeitswerkzeuge und beruhen nicht auf einer Erhebung. Zuletzt aktualisiert: 18.11.2026.