RAG oder Fine-Tuning: Wie ein Mittelständler KI mit eigenen Daten nutzt
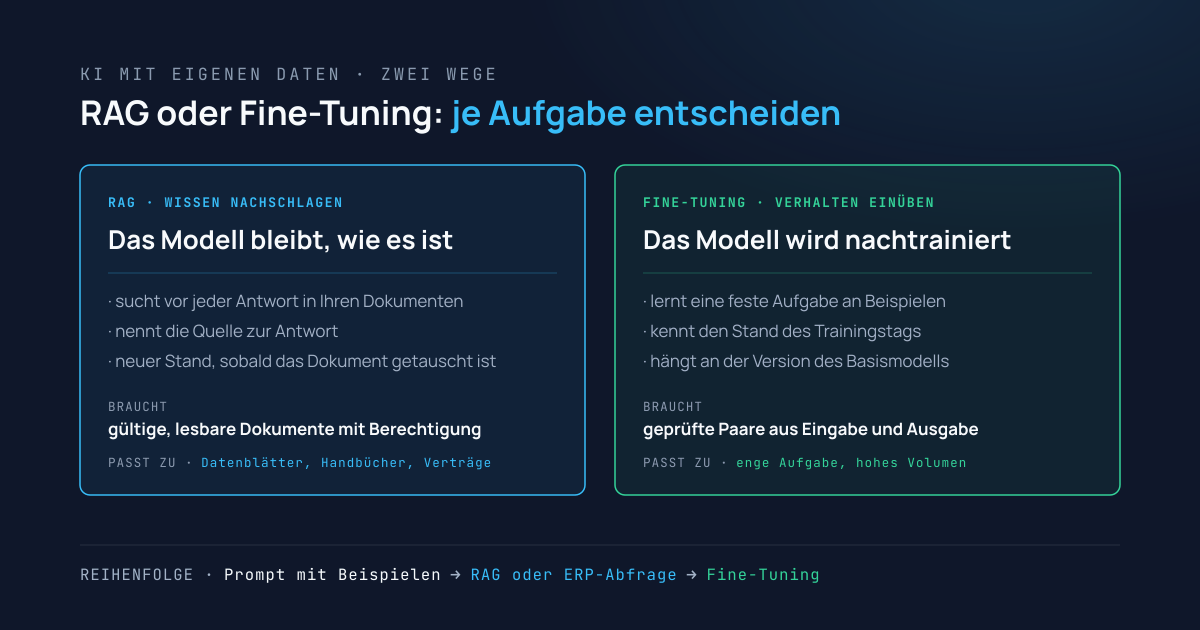
„Können wir die KI nicht einfach mit unseren Daten trainieren?“ Die Frage stellt sich in vielen Betrieben früh, meist in der Geschäftsführung. Gemeint ist: Das Modell soll unsere Artikel, Kunden und Abläufe kennen. Dafür gibt es zwei Wege, die oft verwechselt werden. Der eine heißt RAG, der andere Fine-Tuning, und sie lösen unterschiedliche Probleme.
Ein Hinweis vorab: Dagentic baut RAG-Wissenssysteme. Lesen Sie die Abschnitte zu RAG entsprechend kritisch. Dieser Beitrag nennt deshalb auch die Fälle, in denen keiner der beiden Wege der richtige ist.
Worum es geht: die Kurzfassung
- RAG liefert Wissen, Fine-Tuning übt ein Verhalten ein. RAG gibt dem Modell bei jeder Anfrage die passenden Stellen aus Ihren Dokumenten mit. Fine-Tuning verändert das Modell selbst, mit Beispielpaaren aus Eingabe und gewünschter Ausgabe.
- Für Faktenwissen ist RAG der stärkere Weg. In einer Vergleichsstudie schnitt RAG durchgängig besser ab als das Nachtrainieren mit Rohtexten, bei bekanntem wie bei neuem Wissen (Ovadia et al., arXiv, Fassung vom 30.01.2024).
- Fine-Tuning braucht geprüfte Beispiele, keine Dokumentenberge. OpenAI nennt mindestens 10 Beispiele und sieht Verbesserungen ab 50 bis 100 (OpenAI-Dokumentation, abgerufen am 17.11.2026). Ein PDF-Archiv enthält kein einziges solches Beispiel.
- Der Aufwand steckt in den Daten. 50 Prozent der KI-Anwender nennen die Aufbereitung von Daten als großen Kostenpunkt (Bitkom, 14.09.2026, 603 Unternehmen).
- Die Reihenfolge für ein KMU: erst ein guter Prompt mit Beispielen, dann RAG oder ein direkter Zugriff auf das ERP, Fine-Tuning zuletzt und nur für eine feste Aufgabe mit hohem Volumen.
Was ist der Unterschied zwischen RAG und Fine-Tuning?
RAG (Retrieval-Augmented Generation) lässt das Sprachmodell unverändert. Vor jeder Antwort sucht das System in Ihren Dokumenten die passenden Stellen und gibt sie dem Modell mit. Fine-Tuning trainiert das Modell mit Beispielen nach, bis es eine Aufgabe auf eine bestimmte Art erledigt. Das Wissen steckt dann in den Gewichten des Modells.
Ein Bild aus dem Betrieb hilft. RAG ist die neue Kollegin, die vor jeder Auskunft im Ordner nachschlägt und die Seite nennt, auf der es steht. Fine-Tuning ist die Einarbeitung: Nach drei Monaten weiß sie, wie eine Auftragsbestätigung bei Ihnen aussieht und in welchem Ton Sie Kunden antworten. Was gestern im Ordner geändert wurde, weiß sie dadurch nicht.
Den Begriff RAG hat ein Team um Patrick Lewis 2020 geprägt (Lewis et al., NeurIPS 2020). Die Arbeit beschreibt Modelle, die ein trainiertes Gedächtnis mit einem nachschlagbaren verbinden. Wie ein solches System im Alltag arbeitet, erklärt der Beitrag RAG: KI mit Ihren eigenen Daten.
Warum scheitert „mit unseren Dokumenten trainieren“ so oft?
Weil ein Sprachmodell Fakten aus Rohtexten schlecht lernt. Ovadia und Kollegen haben beide Wege direkt verglichen: RAG war durchgängig besser, und die Modelle taten sich schwer, neue Fakten durch Nachtrainieren aufzunehmen. Besser wurde es erst, wenn dieselbe Tatsache in vielen Formulierungen im Trainingsmaterial stand (arXiv 2312.05934).
Für einen Großhändler heißt das: Eine Preisliste, die einmal im Trainingsmaterial vorkommt, kann das Modell danach nicht zuverlässig wiedergeben. Es antwortet flüssig und trotzdem falsch, und es nennt keine Quelle, an der Ihr Innendienst die Auskunft prüfen könnte.
Dazu kommt die Aktualität. Preise, Bestände und Konditionen ändern sich täglich. Ein RAG-System liest den neuen Stand, sobald das Dokument ausgetauscht ist. Ein nachtrainiertes Modell kennt den Stand des Trainingstags, bis jemand neu trainiert.
Welche Datenmengen brauchen Sie für RAG?
Für RAG gibt es keine Mindestmenge. Ein System über 200 Datenblätter funktioniert nach demselben Prinzip wie eines über 50.000 Dokumente. Über die Qualität der Antworten entscheidet, ob die Dokumente aktuell, widerspruchsfrei und einer Berechtigung zugeordnet sind.
Drei Dinge prüfen Sie vor dem Start:
- Gibt es eine gültige Fassung? Liegen drei Versionen der Rücknahmeregelung im Laufwerk, findet die Suche alle drei. Das Modell kann nicht wissen, welche gilt.
- Ist der Text lesbar? Gescannte Lieferantenkataloge brauchen eine Texterkennung, Tabellen in PDF-Dateien eine eigene Behandlung.
- Wer darf was sehen? Einkaufskonditionen gehören nicht in die Antwort an den Außendienst. Die Berechtigung muss an jedem Dokument hängen, bevor es in den Index kommt.
Am unteren Ende ist RAG oft unnötig. Passt das gesamte Wissen in eine Anfrage, etwa ein Handbuch und eine Preisliste, geben Sie es dem Modell direkt mit. Das ist einfacher zu betreiben und leichter zu prüfen. Wo Antworten trotz RAG schlecht ausfallen, liegt es meist an der Suche und selten am Modell; den Mechanismus beschreibt unser englischsprachiger Beitrag Most RAG Problems Are Retrieval Problems.
Welche Datenmengen brauchen Sie für Fine-Tuning?
Fine-Tuning zählt Beispiele. Ein Beispiel ist ein Paar aus Eingabe und richtiger Ausgabe, etwa eine eingegangene E-Mail und die Kategorie, in die Ihr Innendienst sie einsortiert hat. OpenAI nennt als Untergrenze 10 Beispiele, sieht Verbesserungen ab 50 bis 100 und empfiehlt, mit 50 sorgfältig erstellten Beispielen zu beginnen (OpenAI-Dokumentation).
Dieselbe Dokumentation enthält zwei Sätze, die für die Planung mehr wert sind als die Zahlen. Bringen 50 Beispiele nichts, sollen Sie Aufgabe oder Prompt überdenken, bevor Sie weitere Daten sammeln. Und Fine-Tuning lohnt erst, wenn ein Testsatz steht, an dem sich vorher und nachher messen lässt.
Wie viele Beispiele Sie am Ende brauchen, hängt von der Aufgabe ab; eine allgemeine Zahl nennt keine seriöse Quelle. Fragen Sie deshalb zuerst, woher die Paare kommen. Gute Quellen im Handel sind Vorgänge, bei denen die richtige Antwort schon im System steht: die Ablage, in die eine E-Mail verschoben wurde, der Artikel, dem ein Sachbearbeiter eine Freitext-Position zugeordnet hat, die Reklamation mit ihrer späteren Einstufung. Solche Daten entstehen als Nebenprodukt der täglichen Arbeit. Wo sie fehlen, muss jemand vom Fach die Beispiele von Hand prüfen, und das ist der eigentliche Preis.
Die Rechenleistung ist seltener das Hindernis. Das Verfahren LoRA trainiert nur kleine Zusatzmatrizen und lässt das Modell selbst unverändert. In der Originalarbeit sank die Zahl der trainierten Parameter gegenüber dem vollständigen Nachtraining von GPT-3 um den Faktor 10.000, der Bedarf an Grafikspeicher um den Faktor 3 (Hu et al., 2021). Damit lässt sich ein offenes Modell auf eigener Hardware anpassen.
Für welche Aufgaben im Großhandel passt welcher Weg?
Ordnen Sie jede Aufgabe einzeln zu, nie den ganzen Betrieb. Die Tabelle ist ein eigenes Arbeitswerkzeug für das Gespräch zwischen IT-Leitung und Fachabteilung und beruht nicht auf einer Erhebung.
| Aufgabe | Passender Weg | Begründung |
|---|---|---|
| Produktauskunft aus Datenblättern und Katalogen | RAG | Faktenwissen, ändert sich, Quelle muss prüfbar sein |
| Wissen erfahrener Kollegen sichern | RAG | Dokumente und Notizen bleiben durchsuchbar und zitierbar |
| Preis, Bestand, Kondition eines Kunden | Abfrage im ERP | Strukturierte Daten liest das System direkt, ohne Suche in Texten |
| Bestellung aus E-Mail oder PDF lesen | Prompt mit festem Ausgabeformat, Abgleich mit dem Artikelstamm | Die Prüfung gegen das ERP entscheidet über das Ergebnis |
| Freitext-Position einem Artikel zuordnen | Suche im Artikelstamm, dazu die Tabelle früherer Zuordnungen | Bekannte Zuordnungen sind sicherer als jede Schätzung |
| Posteingang in feste Kategorien sortieren | Prompt mit Beispielen; Fine-Tuning bei hohem Volumen | Enge, stabile Aufgabe, Beispiele liegen im Postfach |
| Antworten und Angebotstexte im Hausstil | Prompt mit Beispielen; Fine-Tuning selten nötig | Stil lässt sich mit wenigen Mustern vorgeben |
Die dritte Zeile wird am häufigsten übersehen. Wer wissen will, welchen Preis Kunde 4711 für einen Artikel bekommt, braucht eine Abfrage im ERP. Ein Sprachmodell formuliert die Frage dafür um und die Antwort danach aus. Wie dieser Zugriff sauber gebaut wird, steht im Beitrag zur ERP-Anbindung für KI-Agenten. Die Zuordnung von Freitext zu Artikeln hängt am gepflegten Artikelstamm, siehe Stammdaten als Engpass für KI-Projekte.
Wann lohnt sich Fine-Tuning für ein KMU?
Fine-Tuning lohnt sich, wenn eine eng umrissene Aufgabe in großer Stückzahl anfällt, geprüfte Beispiele ohnehin vorliegen und ein Testsatz den Gewinn belegt. Fehlt eine der drei Bedingungen, bleibt der Prompt mit Beispielen die bessere Wahl. Fünf Fragen klären das in einer Stunde:
- Ist die Aufgabe stabil? Kategorien, Formate und Regeln sollten sich über Monate nicht ändern. Jede Änderung bedeutet neue Beispiele und ein neues Training.
- Liegen Paare aus Eingabe und richtiger Ausgabe vor? Am besten als Nebenprodukt der bisherigen Arbeit, mit Datum und Bearbeiter.
- Gibt es einen Testsatz? 100 bis 200 zurückgelegte Fälle, die nie ins Training gehen, reichen als Größenordnung für einen ersten Vergleich; die Zahl ist eine Arbeitsannahme, keine Norm.
- Reicht der Prompt wirklich nicht? Testen Sie ein aktuelles Modell mit zehn guten Beispielen im Prompt gegen denselben Testsatz. Oft ist der Abstand kleiner als erwartet.
- Gibt es einen Grund jenseits der Qualität? Etwa ein kleines Modell auf eigener Hardware, weil Daten das Haus nicht verlassen sollen, oder Kosten und Antwortzeit bei sehr vielen Vorgängen.
Die fünfte Frage ist für den Mittelstand die wichtigste. 45 Prozent der KI-Anwender sorgen sich laut Bitkom, dass Unternehmensdaten in falsche Hände geraten (Bitkom, 14.09.2026). Ein kleines offenes Modell, das für eine Aufgabe nachtrainiert wurde und im eigenen Netz läuft, ist dafür eine legitime Antwort. Was solche Modelle leisten und welche Hardware sie brauchen, steht im Beitrag KI lokal betreiben. Wer den Posteingang so sortieren will, findet die Aufgabe im Beitrag zur Klassifikation des Posteingangs beschrieben.
Beide Wege schließen sich nicht aus. In einer Studie mit landwirtschaftlichem Fachwissen stieg die Genauigkeit durch Fine-Tuning um mehr als 6 Prozentpunkte und durch RAG um weitere 5 (Balaguer et al., arXiv, Fassung vom 30.01.2024). Bitkom-Präsident Ralf Wintergerst sagt es in der Presseinformation zur Studie allgemeiner: „Bei KI geht es nicht in erster Linie um das eingesetzte Modell.“
Welche Risiken bringt Fine-Tuning mit, die RAG nicht hat?
Drei: die Bindung an ein Basismodell, das Löschen von Daten und die Rolle nach dem EU AI Act. Keines davon verbietet Fine-Tuning. Jedes gehört in die Entscheidung, bevor Beispiele gesammelt werden.
Bindung an das Basismodell. Ein nachtrainiertes Modell hängt an der Version, auf der es beruht. OpenAI führt seine Fine-Tuning-Plattform laut eigener Dokumentation zurück: Neue Nutzer erhalten keinen Zugang mehr, berechtigte Bestandskunden können bis zum 6. Januar 2027 Trainingsaufträge anlegen (Stand der Dokumentation am 17.11.2026). Ein RAG-System wechselt das Modell, ohne dass die Wissensbasis neu gebaut werden muss. Wer nachtrainiert, sollte die Beispiele und den Testsatz als eigentliches Vermögen behandeln, denn beide überleben jeden Modellwechsel.
Löschen personenbezogener Daten. Im RAG-System entfernen Sie ein Dokument aus dem Index, und es taucht in keiner Antwort mehr auf. Bei einem trainierten Modell ist das schwieriger. Der Europäische Datenschutzausschuss hält fest, dass mit personenbezogenen Daten trainierte Modelle nicht in jedem Fall als anonym gelten können und der Einzelfall zu prüfen ist (EDPB, Stellungnahme 28/2024 vom 17.12.2024). Bereinigen Sie Trainingsbeispiele deshalb um Namen und Kontaktdaten, bevor Sie trainieren.
Rolle nach dem EU AI Act. Wer ein Modell verändert, wird nach den Leitlinien der EU-Kommission erst dann selbst Anbieter eines KI-Modells mit allgemeinem Verwendungszweck, wenn die Veränderung mehr als ein Drittel der Trainingsrechenleistung des ursprünglichen Modells benötigt (Leitlinien der Kommission, veröffentlicht am 18.07.2025, Nr. 60). Ein Nachtraining im Mittelstand liegt weit darunter. Die übrigen Pflichten ordnet der Beitrag zu EU AI Act und DSGVO bei KI-Agenten ein.
Häufige Fragen
Was ist der Unterschied zwischen RAG und Fine-Tuning? RAG lässt das Sprachmodell unverändert und gibt ihm bei jeder Anfrage die passenden Stellen aus Ihren Dokumenten mit. Fine-Tuning trainiert das Modell mit Beispielpaaren aus Eingabe und gewünschter Ausgabe nach und verändert damit sein Verhalten. RAG liefert Wissen, Fine-Tuning übt eine Arbeitsweise ein.
Wie viele Daten braucht man für Fine-Tuning? Weniger Dokumente als gedacht, aber mehr geprüfte Beispiele. OpenAI nennt in seiner Dokumentation mindestens 10 Beispiele und sieht Verbesserungen ab 50 bis 100 Beispielen, je nach Aufgabe deutlich mehr. Gezählt werden Paare aus Eingabe und richtiger Ausgabe. Ein Ordner mit 10.000 PDF-Dateien enthält kein einziges solches Paar.
Kann man eine KI mit den eigenen Firmendokumenten trainieren? Technisch ja, für Faktenwissen ist es der schwächere Weg. In einer Vergleichsstudie von Ovadia und Kollegen (2024) schnitt RAG durchgängig besser ab als das Nachtrainieren mit Rohtexten. Wer Antworten aus Handbüchern, Verträgen oder Datenblättern braucht, baut zuerst ein RAG-System und behält die Quellenangabe.
Ist RAG oder Fine-Tuning günstiger? Das hängt von der Aufgabe ab. Bei RAG entstehen die Kosten in der Aufbereitung der Dokumente und im laufenden Betrieb der Suche. Beim Fine-Tuning entstehen sie in den geprüften Beispielen, im Testsatz und in jedem erneuten Training, wenn das Basismodell wechselt. In der Bitkom-Befragung vom September 2026 nennen 50 Prozent der KI-Anwender die Aufbereitung von Daten als großen Kostenpunkt.
Lassen sich RAG und Fine-Tuning kombinieren? Ja. In der Studie von Balaguer und Kollegen (2024) stieg die Genauigkeit durch Fine-Tuning um mehr als 6 Prozentpunkte und durch RAG um weitere 5 Prozentpunkte. Sinnvoll ist die Kombination, wenn ein nachtrainiertes Modell eine feste Aufgabe erledigt und dafür aktuelle Fakten aus Ihren Systemen braucht.
Werden wir durch Fine-Tuning zum Anbieter eines KI-Modells nach dem EU AI Act? In aller Regel nein. Nach den Leitlinien der EU-Kommission gilt als Richtkriterium, dass die Veränderung mehr als ein Drittel der Trainingsrechenleistung des ursprünglichen Modells benötigt. Ein Nachtraining mit einigen hundert oder tausend Beispielen liegt weit darunter. Ihre Pflichten als Betreiber eines KI-Systems bleiben davon unberührt.
Wo Sie anfangen, wenn Sie heute starten möchten
Schreiben Sie die drei Fragen auf, die Ihr Innendienst am häufigsten an Kollegen weiterreicht, und notieren Sie zu jeder, wo die Antwort heute steht: in einem Dokument, im ERP oder im Kopf einer Person. Steht sie im Dokument, ist es ein Fall für RAG. Steht sie im ERP, brauchen Sie eine Abfrage. Steht sie im Kopf, muss sie zuerst aufgeschrieben werden; wie das geht, beschreibt der Beitrag zur Wissenssicherung vor dem Ruhestand. Fine-Tuning kommt in dieser Liste meist gar nicht vor.
Wenn Sie Ihre Liste besprechen möchten, vereinbaren Sie ein Erstgespräch. Wir sagen auch, wenn ein Prompt und eine saubere ERP-Abfrage genügen. Den größeren Rahmen gibt der Überblick zu KI-Agenten im Mittelstand.
Quellen: Ovadia et al., „Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs“, arXiv 2312.05934, Fassung vom 30.01.2024; Balaguer et al., „RAG vs Fine-tuning: Pipelines, Tradeoffs, and a Case Study on Agriculture“, arXiv 2401.08406, Fassung vom 30.01.2024; Hu et al., „LoRA: Low-Rank Adaptation of Large Language Models“, arXiv 2106.09685, 2021; Lewis et al., „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“, NeurIPS 2020; OpenAI-Dokumentation zum überwachten Fine-Tuning, abgerufen am 17.11.2026; Bitkom-Presseinformation „Erstmals nutzt die Mehrheit der Unternehmen KI“ vom 14.09.2026 (603 Unternehmen ab 20 Beschäftigten); Leitlinien der EU-Kommission zu den Pflichten für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck, veröffentlicht am 18.07.2025; EDPB, Stellungnahme 28/2024, angenommen am 17.12.2024. Die Studien von Ovadia und Balaguer prüfen einzelne Modelle und Fachgebiete; ihre Ergebnisse sind Anhaltspunkte, keine Garantie für Ihren Fall. Die Tabelle der Aufgaben, die fünf Fragen und die Größe des Testsatzes sind eigene Arbeitswerkzeuge und beruhen nicht auf einer Erhebung. Dagentic baut RAG-Wissenssysteme. Zuletzt aktualisiert: 17.11.2026.